
Claude 模型家族怎麼選?給臺灣開發團隊的 production-grade LLM 評估指南
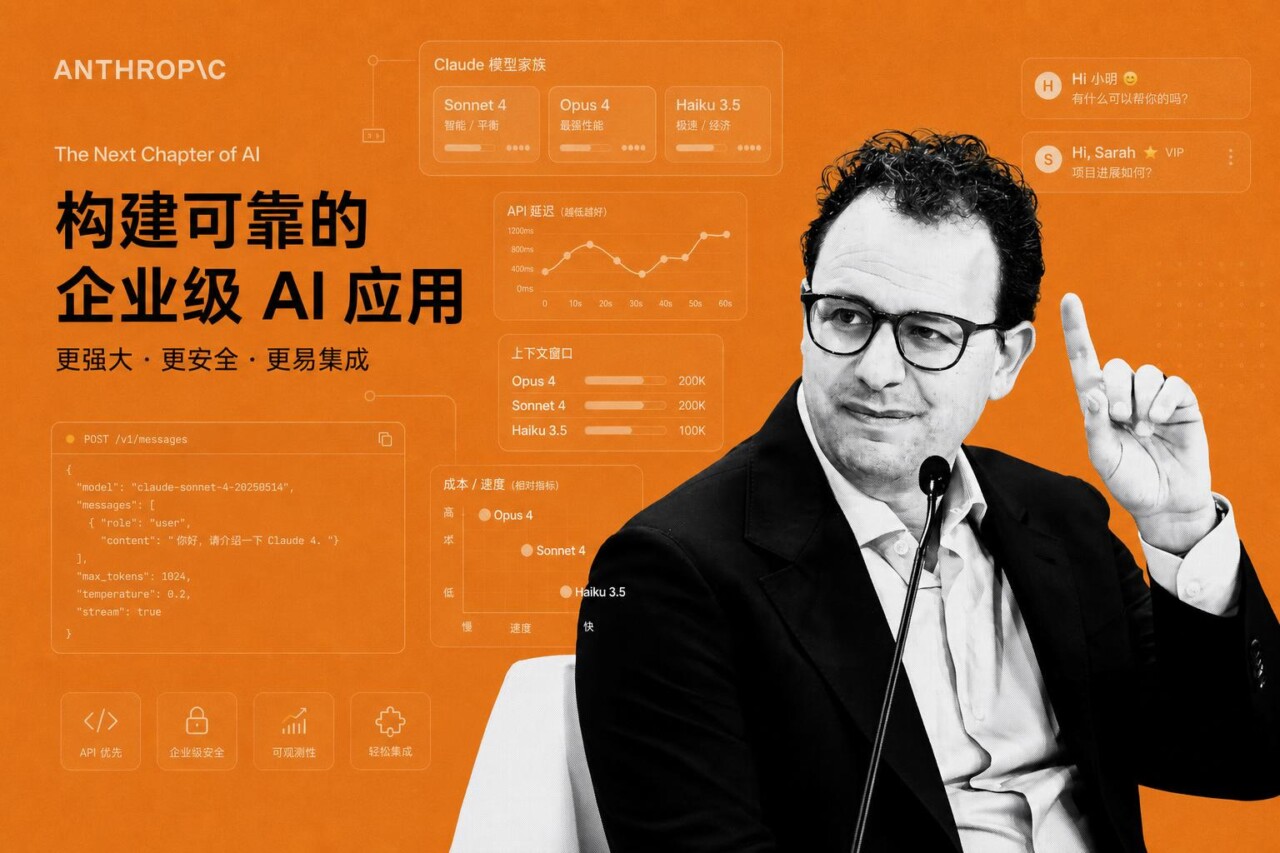
如果你的團隊已經在 GPT 生態投入不少時間,現在才開始評估 Claude,真正的問題通常不是「Claude 聰不聰明」,而是「它在哪些 production 場景值得多放一條供應商路線」。對中高階開發者、AI 應用團隊和 CTO 來說,模型選型不該只看單次 benchmark 排名,而要看可靠性、長上下文、工具調用、資安審查、成本結構,以及遷移後是否能降低長期維運風險。
Anthropic 近年的 Claude 模型家族已經形成清楚分工:Opus 處理高難度推理與長任務,Sonnet 承擔日常開發與高流量產品,Haiku 則主打低延遲與成本效率。本文用技術決策視角整理 Claude Opus 4.8、Claude Sonnet 4.6、Claude Haiku 4.5、Claude API、Model Context Protocol 與 tool use,讓你能把它放進團隊的 LLM 選型會議,而不是隻停留在品牌印象。
Claude 模型家族為什麼值得重新評估?
過去許多開發者對 Anthropic 的印象是「安全、保守、文字能力強」。這個印象沒有錯,但已經不完整。從 Claude 4 系列開始,Anthropic 把模型定位往 coding、agentic workflows、長上下文分析與 enterprise workflows 明確推進。官方 Opus 頁面將 Claude Opus 4.8 定位為適合 serious coding、AI agents 與知識工作,並標示 1M context window;Sonnet 4.6 則被定位為能支援 real-time agents 與 high-volume work 的混合推理模型。
這對臺灣開發團隊的意義很實際:當你要把 LLM 接進內部文件搜尋、客服代理、程式碼重構、資安稽核輔助或資料分析流程時,模型不只要「回答得好」,還要在多輪工具調用、長任務與不完整資訊下維持一致性。這正是 Claude 目前最值得被放進 PoC 的位置。
另一個重點是供應商風險。若團隊只依賴單一模型供應商,後續在成本、可用性、模型退版、合規審查與產品路線上都會降低談判彈性。把 Claude 納入評估,不代表立刻替換既有 GPT 解法,而是建立第二條高可信度模型路線。
Claude Opus 4.8、Sonnet 4.6、Haiku 4.5 差在哪裡?
從開發團隊的角度,Claude 模型家族可以先用一個簡單框架理解:Opus 看品質上限,Sonnet 看 production 平衡,Haiku 看吞吐與成本。
Claude Opus 4.8 適合最難、最長、最需要判斷力的工作。例如跨服務程式碼理解、大型 refactor 規劃、複雜文件比對、多步驟 agent 任務,或需要模型主動指出輸入矛盾的分析工作。Anthropic 官方頁面列出 Opus 4.8 的 pricing 起點為每百萬 input tokens 5 美元、output tokens 25 美元,並提到 prompt caching 最高可節省 90% input 成本。這表示 Opus 不一定適合所有請求,但適合放在「品質失敗成本很高」的任務層。
Claude Sonnet 4.6 則比較像多數團隊的日常主力。官方 Sonnet 頁面指出 Sonnet 4.6 可用於 coding、agents、computer use 與 enterprise workflows,API beta 支援 1M token context window,價格起點為每百萬 input tokens 3 美元、output tokens 15 美元。對產品團隊來說,Sonnet 通常會是第一個 PoC 對象:它夠強、延遲與成本較可控,也適合承擔大量使用者互動。
Claude Haiku 4.5 則應該被視為「低延遲任務層」。根據 Claude API models overview,Haiku 4.5 的 comparative latency 為 fastest,context window 為 200k tokens,價格為每百萬 input tokens 1 美元、output tokens 5 美元。它適合分類、摘要、輕量資料抽取、即時介面輔助、初步 routing,或把昂貴模型前面的雜訊先清掉。
| 模型 | 適合任務 | 技術主管該問的問題 |
|---|---|---|
| Claude Opus 4.8 | 複雜 coding、長任務 agents、高價值文件分析 | 失敗成本是否高到值得使用最高品質模型? |
| Claude Sonnet 4.6 | 日常 coding、產品內 AI 功能、高流量 agent | 是否能在品質、成本、延遲之間取得穩定平衡? |
| Claude Haiku 4.5 | 快速分類、摘要、routing、低成本批次處理 | 任務是否需要低延遲,而非最強推理? |
1M context window 的價值,不是把更多文字塞進 prompt
很多團隊看到 1M context window,第一反應是「可以放整個 codebase」。這是方向,但不是完整答案。長上下文真正的價值在於降低資訊切片造成的判斷失真:模型能同時看到 API contract、測試、文件、錯誤日誌、PR 討論與相依模組,才有機會做出接近 senior engineer 的判斷。
不過,長 context 不是免費午餐。上下文越長,成本、延遲與 prompt hygiene 都會變成工程問題。Claude 的 Prompt Caching 因此很關鍵:如果團隊要反覆查詢同一份規格書、同一批政策文件或同一個大型 repository,快取可以讓固定上下文不必每次都用完整 input 成本重算。這也是為什麼 1M context 要和 caching、batch processing、RAG 策略一起評估,而不是單獨拿來當行銷數字。
實務上,建議把 1M context 用在三類場景。第一,長文件理解,例如法務條款、技術規格、投標文件、研究報告。第二,大型程式碼庫分析,例如跨模組 bug tracing、legacy modernization、migration planning。第三,長任務代理,例如需要模型在多次工具調用後仍記得原始任務目標的 agentic workflows。
tool use、Computer Use 與 MCP:Claude 的生態重點
評估 Claude 時,不要只看聊天介面。對開發團隊更重要的是 Claude API、tool use、Computer Use、Claude Code 與 Model Context Protocol。這些能力決定模型能不能從「回答問題」進一步變成「可控地執行工作」。
tool use 的核心是讓模型在需要時呼叫外部工具,例如查資料庫、讀文件、執行內部 API、跑測試或建立工單。這會把 LLM 從單一文字生成器變成工作流節點,但也提高了安全要求:工具權限、輸入驗證、審計紀錄、失敗回滾、rate limit 都要先設計。Claude 在這類任務上的價值,來自它偏向謹慎、會表達不確定性的互動風格;對 production agent 來說,知道什麼時候不該執行,往往和會執行一樣重要。
MCP 則值得技術主管特別關注。它提供一種連接模型與工具、資料源的標準化方式,讓團隊不必為每個模型供應商重寫整套 integration。對正在避免 vendor lock-in 的團隊,MCP 的價值不只在 Anthropic 生態,而在於它把 context、tool 與 agent workflow 的邊界變得更清楚。
和 GPT-4o、Gemini 比,Claude 應該怎麼放進選型表?
Claude 不需要被包裝成唯一答案。更務實的做法,是把它和現有供應商放進同一張任務矩陣。
若你的產品需要成熟的多模態應用、廣泛工具與市場採用度,OpenAI GPT-4o 仍然是強勢基準。若你高度依賴 Google Cloud、生態整合或超長上下文,Google Gemini 也會是合理選項。Claude 的切入點則更偏向可靠 coding、長上下文專業工作、可控 agentic workflows,以及團隊希望模型能在不確定時清楚說明限制的場景。
選型會議可以用四個問題快速分類:
- 任務失敗後,會只是使用者體驗下降,還是會造成資料錯誤、流程中斷或工程事故?
- 任務是否需要讀取大量既有上下文,例如 repo、文件、日誌、規格和歷史討論?
- 模型是否需要多次呼叫工具,並在中途修正路線?
- 團隊是否需要第二供應商,以降低成本與可用性風險?
如果上述問題有兩個以上答案是「是」,Claude 就值得進入正式 PoC,而不是隻做一次聊天測試。
導入 Claude API 前,先設計這 5 個工程檢查點
第一,建立任務分層。不要讓所有請求都打到同一個模型。低風險 routing 給 Haiku,高流量核心互動給 Sonnet,高價值長任務再升級到 Opus。這樣能讓成本曲線更接近真實業務價值。
第二,定義可觀測性。production-grade LLM 不能只看平均延遲,還要記錄 token usage、tool call 次數、cache hit rate、失敗類型、人工接手率與使用者修正率。沒有這些數據,團隊很難判斷 Claude 是真的改善工作流,還是隻是換了一個模型名稱。
第三,設計 fallback。模型 API 可能延遲、限流或輸出低信心答案。系統應該知道什麼情況下改用較小模型、排入批次、要求人工確認,或回退到既有供應商。這對 B2B 產品尤其重要,因為企業客戶通常更在意穩定性。
第四,管理 prompt 與 context。1M context 不代表可以把所有資料無差別塞進去。好的 context pipeline 應該先做資料清理、分段、權限過濾、版本標記與引用追蹤。長上下文若沒有治理,反而會把過期資訊、權限外資料與噪音一起送進模型。
第五,建立安全邊界。Claude 的 Constitutional AI 與 Anthropic 的 AI safety 路線是重要品牌特徵,但團隊仍需自行處理應用層風險,例如 PII 遮罩、prompt injection 防護、工具權限最小化、資料留存政策與審計紀錄。模型安全性是起點,不是完整系統設計。
一個務實的 PoC 路線:從 Sonnet 4.6 開始
如果團隊還沒有 Claude 經驗,建議不要一開始就做全產品遷移。比較合理的路線是選一個目前 GPT 解法表現不穩的任務,用 Claude Sonnet 4.6 做平行 PoC。
第一週,選定單一任務,例如複雜 bug triage、長文件摘要、客服工單分類或內部知識庫問答。第二週,建立 baseline:用現有模型記錄成功率、人工修正時間、token 成本與延遲。第三週,把同一批樣本交給 Sonnet 4.6,評估輸出品質、可引用性、工具調用穩定度與錯誤型態。第四週,再把少數高難度 case 升級到 Opus 4.8,確認是否值得建立 model escalation policy。
這條路線的優點是清楚、低風險,也能讓技術主管把討論從「我覺得 Claude 比較好」變成「在 200 筆樣本中,Claude 減少了多少人工修正時間」。對工程組織來說,這才是能說服預算與架構決策的語言。
Claude 模型家族常見問題
Claude 適合直接取代 GPT 嗎?
不一定。比較健康的策略是先做任務分流,而不是全面替換。GPT 生態成熟,適合保留既有穩定流程;Claude 可以先切入長上下文、coding、agentic workflows 與高可靠性要求的場景。當 PoC 數據足夠,再決定是否擴大導入。
Opus、Sonnet、Haiku 要怎麼搭配?
把 Haiku 放在低成本快速任務,把 Sonnet 放在主要產品互動,把 Opus 留給高難度、長任務與需要更高判斷力的工作。這種三層架構通常比單一模型策略更容易控制成本。
Claude 的 1M context window 是否代表不用 RAG?
不是。長 context 可以降低切片失真,但 RAG 仍然負責檢索、權限控制、版本管理與引用追蹤。對 enterprise workflow 來說,1M context 和 RAG 是互補,不是替代。
哪些官方頁面值得先讀?
可以從 Claude Opus、Claude Sonnet、Claude Haiku 與 Claude API models overview 開始。這些頁面能快速確認模型定位、context window、pricing、latency 與 API 型號名稱。
結論:把 Claude 當成工程選型,不是品牌信仰
Claude 模型家族最值得臺灣開發團隊關注的,不是它是否在每個榜單都第一,而是它提供了一條偏可靠、可控、長上下文友善的 production-grade LLM 路線。Opus 4.8、Sonnet 4.6、Haiku 4.5 的分工清楚,Claude API 與 MCP 生態也讓它更容易被放進實際工作流,而不是隻停在 demo。
若你的團隊正在重新檢視 LLM 成本、供應商風險、長 context 任務或 coding agent 的可靠性,下一步不是開一場抽象討論,而是選一個高痛點任務,用 Anthropic Console 建立第一個 Sonnet 4.6 API call,讓 PoC 數據決定 Claude 應該站在你的架構圖哪一層。


